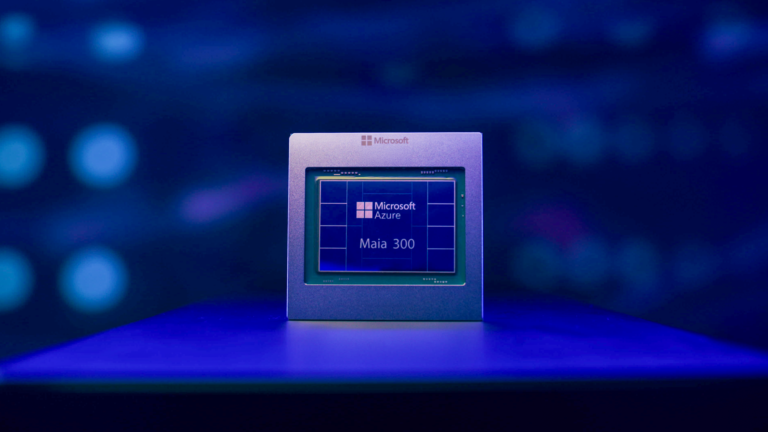
Microsoft presenteert Maia 300, de derde generatie van zijn eigen AI-accelerator. Vanaf 2027 wil het bedrijf de Maia-familie op multi-gigawattschaal uitrollen. Maia wordt dan de belangrijkste inference-hardware voor zijn producten en diensten. Volgens Microsoft levert Maia 300 40 procent meer tokens per megawatt dan GPU-systemen.
Microsoft heeft Maia 300 ontworpen voor AI-workloads die volgens het bedrijf nu in opkomst zijn. Denk aan reasoning over lange context, conversaties waarbij latency telt en agentic taken die uit meerdere stappen bestaan. In een volledige configuratie met 96 accelerators haalt het systeem tot zeven keer de token-throughput per rack van Maia 200.
Die voorganger draait inmiddels in productie. Toen Microsoft Maia 200 onthulde, ging het om een chip op TSMC’s 3nm-proces met 216 GB HBM3e, 7 TB/s bandbreedte en een verbruik van 750 watt. Maia 200 bedient nu Microsoft Copilot en ondersteunt het MAI-team bij de ontwikkeling van nieuwe modellen. GitHub Copilot en Microsoft Foundry volgen voor het einde van dit jaar. Op de chip draaien OpenAI-modellen, Microsofts eigen MAI-modellen en open-source modellen. Ook Anthropic wil Claude-modellen op Maia draaien.
Microsoft rolt Maia 200 uit in de Verenigde Staten, Europa en Australië. Voor de AI-functies in Teams, Copilot en Cowork levert de chip volgens het bedrijf tot 1,7 keer meer tokens per watt dan GPU-infrastructuur.
Geheugen als speerpunt
Bij Maia 300 ligt de nadruk niet op ruwe rekenkracht. “Data efficiënt verplaatsen, in plaats van ruwe rekenkracht, wordt steeds vaker de bottleneck in grote inference-systemen”, schrijft Microsoft. Daarom heeft de chip een software-defined dataflow-architectuur, en optimaliseert AI zelf de kernels.
De specificaties zijn fors. Acht HBM4-stacks leveren samen 18 TB/s geheugenbandbreedte bij een TDP van 950 watt. Dat is ruim het dubbele van Maia 200, terwijl het verbruik met 200 watt stijgt. Daarnaast dient on-die SRAM als scratchpad dat de software zelf beheert.
Maia 300 bestaat uit meerdere chiplets, met aparte chiplets voor compute, geheugencontrollers en I/O. De compute-chiplets maakt TSMC op zijn N2P-procedé. Ook ondersteunt de chip formats met lage precisie, zoals een verbeterde versie van MXFP4. Daardoor kost de KV-cache minder geheugen en kunnen contextvensters groter worden.
Eén rack bevat 96 accelerators en verbruikt 167 kilowatt. Samen hebben ze 27,6 TB HBM-capaciteit en 1,7 PB/s geaggregeerde bandbreedte. Voor scale-up gebruikt Microsoft een eigen AI-transportprotocol op basis van Ethernet, dat van één rack kan opschalen tot een heel datacenter. De eerste productie-uitrol staat gepland voor 2027.
Tip: Microsoft Azure Maia-topman voorspelt een complexe toekomst voor AI-chips